


NGINX Location匹配原理及源码分析

发表于2020-11-28 14:07

浏览 5.9k
一 Location的作用
二配置指令
- 指令location中的正则表达式,就像server_name中一样,可以用小括号()提取变量,供后续其他NGINX模块的指令使用。
- NGINX的location匹配是大小写敏感的。 正则表达式中提供了~*符号用来表示大小写无关。
- 不包含正则的location 在配置文件中的顺序不会影响匹配顺序。而包含正则表达式的 location 会按照配置文件中定义的顺序进行匹配。
- 设置为精确匹配(with = prefix) 的 location 如果匹配请求URI 的话,此location 被马上使用,匹配过程结束。
- 在其它只包含普通字符的 location 中,找到和请求URI 最长的匹配。如果此 server{}没有包含正则的 location或者该locaiton 启用了 ^~的话,这个最 长匹配的 location会被使用。如果此 server{}中包含正则的location,则先在 这些正则 location中进行匹配,如果找到匹配,则使用匹配的正则 location,如果 没找到匹配,依然使用最大匹配的 location。
- ^~, =, ~, ~*这些修饰符和后面的URI 字符串中间可以不使用空格隔开。@ 修饰符必须和URI 字符串(实际上应该叫“命名”) 直接连接。
- location可以嵌套定义。但是要符合以下几条规则:
- = 修饰的 location中不能再嵌套其它location
- @ 修饰的 location中不能再嵌套其它 location
- @ 修饰的 location不能嵌套到其它location 中
- 父location的URI 字符串必须是子location 的URI 字符串的前缀(子location 启用了正则的情况除外)
三 匹配流程
- 先对前缀location执行最长前缀匹配。
- 若最长前缀location前携带有=或者^~,那么使用此location配置块处理请求,不再进行正则匹配。对于=前缀,要求完全相等,对于^~前缀,只有最长匹配前有^~符号,才能跳过正则表达式。
- 按server{ }中正则表达式的出现顺序,依次匹配。成功后就选中此location。正则表达式的查找是按照在配置文件中的顺序进行的。因此正则的顺序很重要,建议越精细的放的越靠前。
- 若所有正则表达式皆未匹配上,则使用第1步中检索出的最长前缀location处理请求。
- 如果在第1步中也没有匹配到最长location,则返回404。
四数据结构
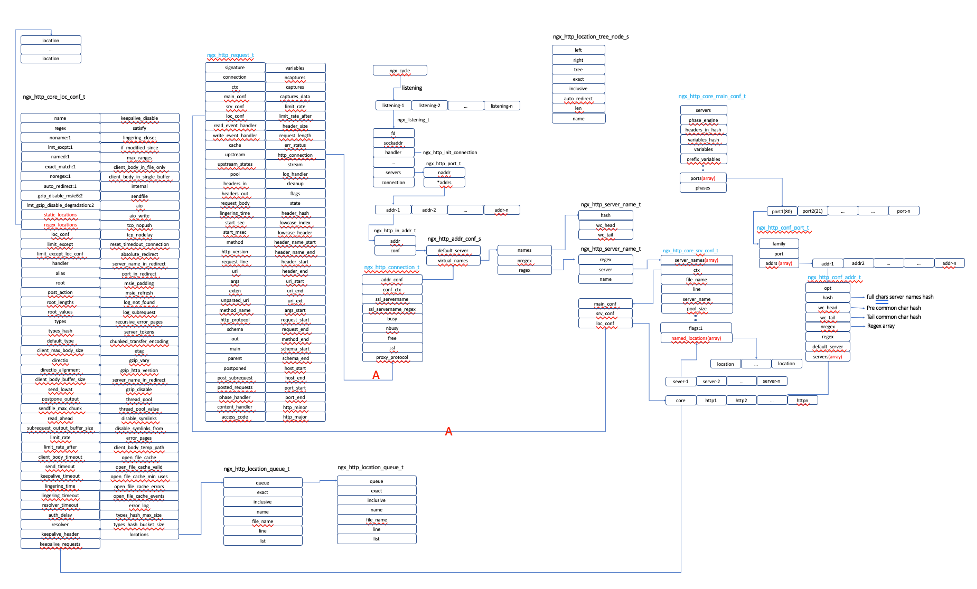
ngx_http_core_loc_conf_s
ngx_http_location_queue_t
五源码分析
配置平面
- 函数会为location生成一个ngx_http_core_loc_conf_s结构用来存储location的定义。
- 首先会根据location的描述符正确生成flags。如果带有@修饰符,则把named flag设置为1。如果是通过if语句定义的,把noname flag设置为1.如果有=修饰符,则exact_match flag会设置为1. 如果有^=符号,则noregex flag会设置为1.
- 对配置进行一些有效性检查。比如带@修饰符的location不能再嵌入到任何别的location里面,而且它本身也不能再嵌入任何别的location等。
- 把最初生成的ngx_http_core_loc_conf_s结构结果通过函数ngx_http_add_location加入到上级ngx_http_core_location中的locations这个queue里面。
- 函数ngx_http_add_location会先成生一个ngx_http_location_queue_t结构,然后根据ngx_http_core_loc_conf_s中的exact_match,regex, named, nonamed flag是否有一个为1,如果条件满足则选择把ngx_http_core_loc_conf_s放入到ngx_http_location_queue_t结构中的exact变量中,反之则会把它放入inclusive变量中。这里说明一下inclusive,它表示URI之间的包含关系,即”/abc/a“这个URI是包含”/abc“的。
- 调用ngx_queue_sort对location queue中的所有locations按照exact(sorted) -> inclusive(sorted) -> regex -> named -> noname的原则进行排序。
- 因为location中还可以再嵌入location。所以,函数ngx_http_init_locations会递归调用,去处理嵌套情况。
- 把所有named的location从location queue里面分离出来然后加入到对应server结构ngx_http_core_srv_conf_t 中的named_locations里面。
- 将正则表达式定义的location分离出来,放置到ngx_http_core_loc_conf_t结构中的regex_locations成员中。
- 把nonamed的location从location queue中删除。
- 完整性检测,比如判断locations queue是否为空,如果是空则直接返回。
- 因为location可以嵌套,所以,函数ngx_http_init_locations递归调用,去处理嵌套情况。
- 调用ngx_http_join_exact_locations把location queue中将当前虚拟主机中 URI字符串完全一致的exact 和inclusive 类型的location 进行合并。
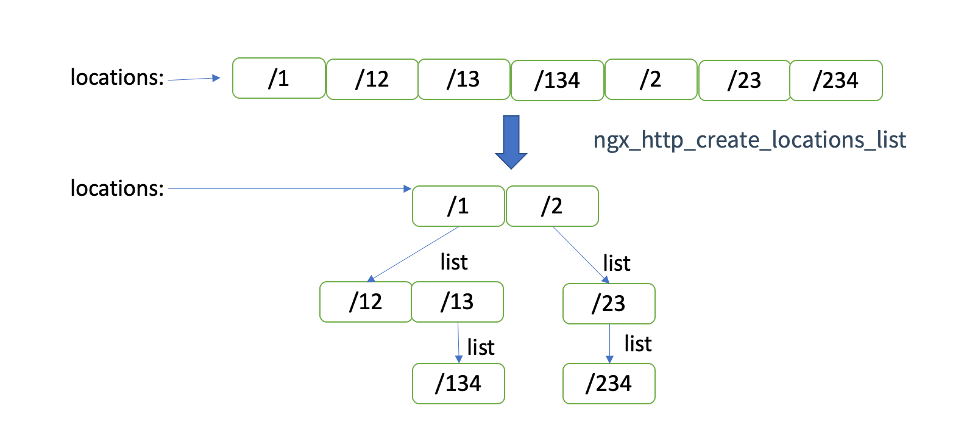
- 调用ngx_http_create_locations_list把locations queue变成locations list。如下图所示就是ngx_http_create_locations_list调用前后的效果。
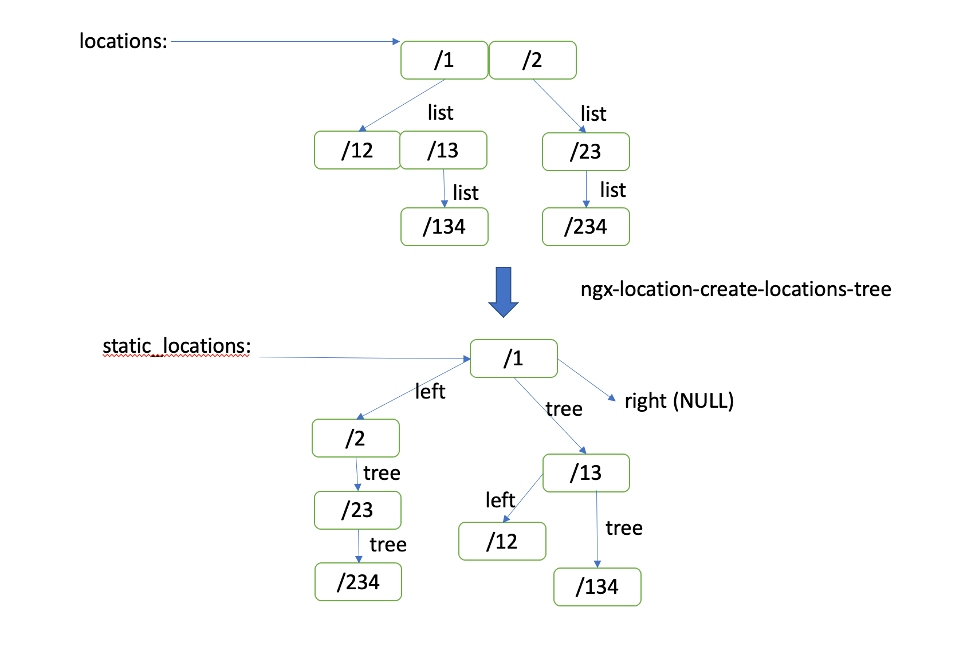
- 调用函数ngx_http_create_locations_tree,在上述创建的list的基础上,进一步生成查找树。首先确定locaiton队列的中间节点,然后从中间节点把location分成两部分。分别再构造左右子树。最后把inclusive类型的location放入到成员tree中。
数据平面
六结语
已修改于2023-03-09 02:08


写下您的评论
全部评论(1)
按点赞数排序
按时间排序


相关文章
上一篇文章介绍了HTTP请求匹配server{}配置块的过程,接着请求会继续匹配location{}配置块,并最终决定哪些指令及Nginx模块处理请求。本文将介绍location的匹配规则,以及rewrite指令与location匹配顺序的关系。 生产环境中的nginx.conf往往含有上百条location,这是因为Nginx常常身兼多职:充当提供静态资源CDN、作为负载均衡为分布式集群提供扩展性、作为APIgateway提供接口服务等等。location一旦配置错误,Nginx上巨大的并发连接数会将错误放大上万倍,很容易导致严重的线上事故。 而location也很容易配置错误,它既支持前缀匹配,也支持正则表达式匹配,当二者同时出现时,为了获得更高的性能,Nginx设计了复杂的location匹配优先级。这是因为前缀匹配是对静态的location多叉树检索完成的,它的性能要比正则表达式高得多,唯有搞清楚具体的匹配流程,我们才能设计出匹配速度更快的location。 而且rewrite指令修改URL的功能也让location匹配变得更为复杂。特别是r
 点赞 12
 浏览 5.4k
我的职业生涯大部分时间都在跟NGINX打交道,有足够的经验分享整个NGINX开发史的演进。本文以事后诸葛的角度揭示怎么形成现在这个生态。此图展示了现如今活跃在NGINX生态的重要开源模块和产品。一切从C开始NGINX是纯C实现的软件,源码质量很高。即使不从事NGINX的人也可以将它作为很好的学习软件。作者Igor很早就有支持脚本语言的意图。所以问题就变成了C如何跟脚本语言引擎的结合了。这些主流脚本语言python,php,v8(js),perl,lua都有C的API,考虑到两方面:轻量级和性能,perl成为了当时的NGINX首选。甚至他还实现了一个迷你的SSI模块,自定义的脚本功能。但是从现在看,个人觉得Lua是和C交互最好的语言,天生为C设计的脚本语言,足够轻量,足够快。@agentzh将Lua引入NGINX,怎么看都是正确和极具工程实用的选择。估计NGINX社区也没料到Lua模块能如此成功。但是呢,Igor一直有脚本语言的情节,于是在2015年NJS诞生了,也是纯C的JS引擎。Lua天生能跟C交互,但不意味着它能天生跟服务器软件交互。这里最大的问题是语言虚拟机的实现。简单讲
点赞 5浏览 7k为了使我们的NginxPlus具有对MQTTBroker的正常工作状况具有主动健康检查的能力,首先我们要了解MQTT的协议的连接。0x01MQTT协议第一节我们介绍过,MQTT是一种基于TCP建立的的一套协议,MQTT报文中也有类似于TCP三次握手的状态码。简单来讲,我们只需要构建一个合法的CONNECT连接,等待MQTT返回一个CONNACK的回应报文,就能确认MQTTBroker正在处于一个正常工作的状态。0x02NginxPlus构建CONNECT1matchmqtt_conn{12#SendCONNECTpacketwithclientID"nginxhealthcheck"13send\x10\x20\x00\x06\x4d\x51\x49\x73\x64\x70\x03\x02\x00\x3c\x00\x12\x6e\x67\x69\x6e\x78\x20\x68\x65\x61\x6c\x74\x68\x20\x63\x68\x65\x63\x6b;14expect\x2
点赞 1浏览 5.6k
保持联系
 微信公众号
 加入微信群


开放 · 包容 · 沟通 · 贡献
Copyright © F5, Inc. All Rights Reserved. F5 版权所有
